Quem acompanha o debate sobre busca com IA já esbarrou em um nome estranho: llms.txt. Em fóruns de SEO, em ferramentas de otimização e em recomendações de consultores, o arquivo aparece como uma espécie de passaporte para ser citado por assistentes de IA. A promessa é sedutora, porque parece simples. Mas será que criar um arquivo resolve a visibilidade da empresa nas respostas de IA? Neste texto, a equipe da Capta Marketing Digital explica o que é llms.txt, o que a documentação do Google diz sobre arquivos de texto para IA e o que realmente sustenta a visibilidade, em tom de esclarecimento e sem desmerecer quem recomenda o arquivo.
A lógica de quem sugere o llms.txt é compreensível: dar aos modelos de linguagem um resumo organizado do site. A questão é saber o que isso, sozinho, entrega. Para responder, o texto parte da proposta original e do guia oficial do Google sobre recursos de IA generativa.
Resposta direta: o llms.txt é uma proposta de arquivo em Markdown, colocado na raiz do site, que resume o conteúdo e lista links importantes para modelos de linguagem. Não é um padrão formal. O guia do Google sobre AI Overviews e Modo IA afirma que não é preciso criar arquivos de texto para IA para aparecer nesses recursos, e que a página precisa estar indexada e ser elegível a exibir um snippet. A visibilidade em respostas de IA depende de uma presença digital estruturada, e o arquivo, no máximo, complementa essa base.
Em resumo:
- O llms.txt é uma proposta aberta à comunidade, e não um padrão formal.
- É um arquivo em Markdown, com nome do site, resumo e listas de links, que fornece contexto, e não regras de acesso.
- O guia do Google não cita o llms.txt pelo nome, mas diz que não é preciso criar arquivos de texto para IA para aparecer em AI Overviews e Modo IA.
- Para aparecer, a página precisa estar indexada e ser elegível a snippet, e a exibição não é assegurada.
- Criar o arquivo é opcional e não substitui a base: conteúdo claro, indexação, links internos e informações consistentes.
O que é o llms.txt
O llms.txt foi proposto por Jeremy Howard e está descrito em llmstxt.org como uma proposta para padronizar um arquivo que dá a modelos de linguagem e agentes informações para usar um site. A página classifica o texto como aberto a contribuições da comunidade, ou seja, não se trata de um padrão formal.
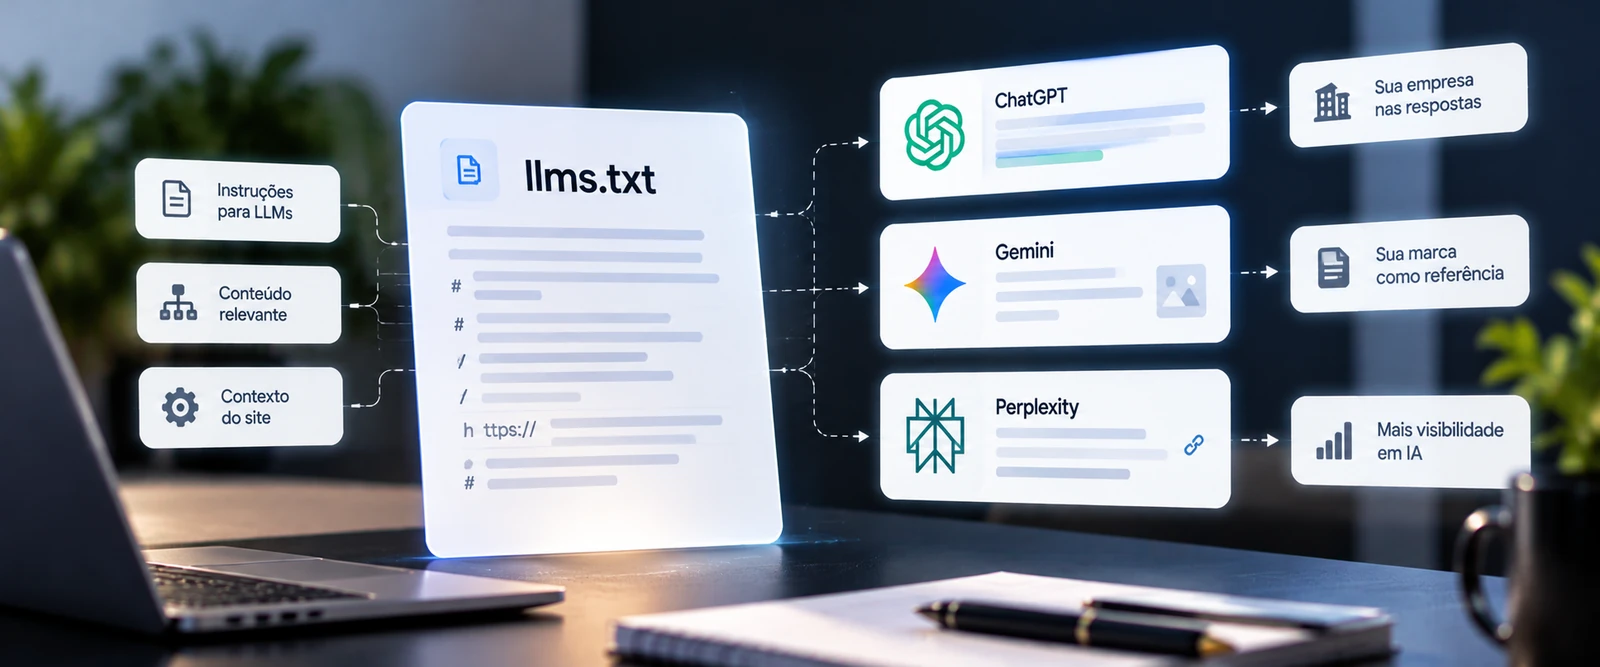
A ideia por trás é simples. Páginas web são feitas para pessoas, com menus, imagens e elementos que dificultam a conversão em texto limpo. O llms.txt oferece um resumo conciso do site em um só lugar, com links para o conteúdo detalhado. O arquivo fica na raiz do site (ou em um subcaminho), é escrito em Markdown e segue uma estrutura:
- Um título com o nome do site, que é a única parte obrigatória.
- Um resumo curto em citação.
- Parágrafos opcionais com informações adicionais.
- Listas de links organizadas em seções, cada uma com um nome e uma descrição opcional.
Segundo a proposta, o uso previsto é principalmente na hora em que um agente ajuda um usuário, ou seja, na consulta, e não no treinamento dos modelos.
Qual a diferença entre llms.txt e robots.txt
Os nomes parecem irmãos, mas as funções são diferentes.
| Ponto | robots.txt | llms.txt |
|---|---|---|
| Função | Orientar quais partes do site podem ser acessadas por rastreadores | Oferecer contexto e um resumo do site para modelos de linguagem |
| Natureza | Mecanismo consolidado de controle de acesso ao rastreamento | Proposta aberta, sem status de padrão formal |
| Formato | Texto com regras de permissão | Markdown com título, resumo e listas de links |
| Papel no Google | Controle principal de acesso ao rastreamento para a Pesquisa | Não citado pelo nome no guia sobre recursos de IA |
Em resumo: o robots.txt trata de acesso, e o llms.txt, como proposto, trata de contexto. Um não substitui o outro.
O que o Google diz sobre arquivos de texto para IA
O guia do Google sobre recursos de IA generativa na Pesquisa é a fonte oficial mais direta para quem quer aparecer em AI Overviews e no Modo IA. Os pontos principais, em linguagem simples:
- Para aparecer como link de apoio, a página precisa estar indexada e ser elegível a ser exibida na Pesquisa com um snippet. O guia não indica outros requisitos técnicos.
- O guia afirma que não há requisitos adicionais nem otimizações especiais para aparecer nesses recursos.
- Segundo o guia, não é preciso criar novos arquivos legíveis por máquina, arquivos de texto para IA ou marcação específica, e também não há dados estruturados do schema.org exclusivos para isso.
- Os recursos podem usar uma técnica chamada query fan-out, que dispara várias buscas relacionadas, por subtópicos e fontes de dados, para encontrar mais páginas de apoio.
Um detalhe de precisão: o guia não menciona o llms.txt pelo nome. O que ele diz, de forma geral, é que arquivos de texto para IA não são necessários. A leitura mais fiel é que, para os recursos de IA do Google, não existe um arquivo específico a criar, e a elegibilidade segue as bases da Pesquisa. A exibição, vale repetir, nunca é assegurada.
Por que o llms.txt não resolve a visibilidade em IA
Há quatro razões para tratar o arquivo como complemento e não como solução.
1. Não é um padrão formal
A própria proposta se apresenta como aberta à comunidade. Isso significa que não há como assegurar que plataformas diferentes o leiam da mesma forma, ou que o leiam.
2. Nos recursos do Google, a elegibilidade vem da base
O guia do Google coloca a indexação e a elegibilidade a snippet como condições. Um arquivo extra não muda isso: se a página não está indexada ou não é elegível, o resumo no llms.txt não a coloca na resposta.
3. A visibilidade depende de conteúdo e de reputação
Assistentes de IA tendem a citar fontes que respondem bem à pergunta e que são consistentes em vários lugares. Isso vem de conteúdo claro, de informações coerentes sobre a empresa e de uma presença digital sólida, e não de um arquivo isolado. O artigo sobre como ChatGPT, Gemini e Perplexity encontram empresas aprofunda essa diferença entre plataformas.
4. Sobre outras plataformas, a documentação consultada não afirma uso
Este texto se baseia na documentação do Google e na proposta original. Sobre o uso do llms.txt por outras plataformas de IA, a documentação consultada não traz afirmação, e por isso o texto também não faz. Quem afirma que determinada plataforma lê o arquivo deveria apontar a fonte oficial.
Então vale a pena criar o llms.txt
Depende do objetivo e do esforço. Sem exagero em nenhuma direção, alguns critérios ajudam.
- Custo: o arquivo é simples de escrever e manter em sites pequenos, mas exige atualização quando o site muda.
- Utilidade possível: pode ajudar agentes que consultem o site, especialmente em conteúdo técnico ou de documentação, segundo a lógica da proposta.
- Limite: não substitui indexação, conteúdo claro e presença consistente, e não há como assegurar efeito na visibilidade.
- Prioridade: a base vem antes. Criar o arquivo sem organizar o resto é como arrumar a vitrine de uma loja com a porta trancada.
Se a decisão for criar o arquivo, o caminho é simples. Primeiro, a empresa define quais páginas realmente representam o negócio, como as de serviços, de contato e de perguntas frequentes. Depois, escreve um resumo curto e fiel do que faz, organiza os links em seções e publica o arquivo na raiz do site. Por fim, inclui a revisão do arquivo na rotina de atualização do site, para que ele não fique desatualizado. Em nenhum desses passos há necessidade de prometer ou esperar um efeito específico: o arquivo é um registro organizado do que o site já tem.
Exemplo hipotético: uma empresa de serviços tem um site com páginas de serviço pouco claras, informações diferentes em cada canal e poucos conteúdos que respondam às dúvidas dos clientes. Se ela só criar o llms.txt, o resumo no arquivo vai refletir a mesma confusão. Se, antes, organizar as páginas, alinhar as informações e cobrir as dúvidas, o arquivo (se quiser criá-lo) ganha conteúdo confiável para resumir. A ordem importa.
O que realmente sustenta a visibilidade em respostas de IA
O próprio guia do Google lista as práticas que continuam valendo. Na prática, elas formam uma base de presença digital:
- Rastreamento e indexação: permitir o acesso no robots.txt e conferir no Search Console se as páginas importantes estão indexadas.
- Conteúdo importante em texto: o que a empresa quer que seja compreendido deve estar escrito, e não apenas em imagens.
- Links internos: ajudam a ligar as páginas e a mostrar o que é importante.
- Experiência na página: páginas claras e rápidas.
- Dados estruturados coerentes: quando usados, devem corresponder ao texto visível.
- Informações atualizadas e consistentes: inclusive em perfis como Business Profile e Merchant Center, quando a empresa os utiliza.
Esse conjunto é o que a Estrutura de Presença Digital da Capta Marketing Digital organiza. Para o recorte entre os dois frentes, vale ler SEO ou GEO: onde uma empresa deve investir agora, e as páginas de SEO e GEO explicam como a visibilidade é trabalhada dentro dos sites que a agência desenvolve. Para acompanhar o efeito, o artigo sobre como medir os AI Overviews no Search Console mostra onde olhar.
Erros comuns ao tratar o llms.txt
- Tratar como atalho. Nenhum arquivo substitui a base de conteúdo e presença.
- Esperar resultado imediato. Não é possível assegurar que a visibilidade mude.
- Copiar modelos sem revisar. Um resumo genérico ou desatualizado confunde mais do que ajuda.
- Esquecer a manutenção. Se o site muda e o arquivo não, ele passa a informar errado.
- Ignorar o que o Google diz. Para os recursos do Google, a documentação aponta para as bases da Pesquisa.
- Atacar quem recomenda. A discussão é técnica, e quem sugere o arquivo parte de uma lógica legítima, a de dar contexto aos agentes.
Perguntas frequentes sobre o llms.txt
O que é llms.txt?
É uma proposta de arquivo em Markdown, colocado na raiz do site, que resume o conteúdo e lista links importantes para modelos de linguagem e agentes.
Para que serve o llms.txt?
A proposta o descreve como uma forma de dar contexto a agentes de IA na hora de consultar o site, de modo concentrado e legível. Não define regras de acesso, como faz o robots.txt.
O Google usa o llms.txt?
O guia do Google sobre recursos de IA não cita o llms.txt pelo nome e afirma que não é preciso criar arquivos de texto para IA para aparecer em AI Overviews e Modo IA.
Preciso criar um llms.txt para minha empresa?
Não é uma exigência dos recursos de IA do Google. Pode ser um complemento opcional, desde que a base de conteúdo e indexação esteja organizada.
O llms.txt melhora a visibilidade em IA?
Não é possível assegurar. A visibilidade depende de indexação, conteúdo claro, informações consistentes e presença digital estruturada.
O llms.txt é igual ao robots.txt?
Não. O robots.txt orienta o acesso de rastreadores, e o llms.txt, como proposto, oferece contexto e um resumo do site.
Conclusão: o que é llms.txt importa menos do que a base que ele resume
Entender o que é llms.txt ajuda a separar a proposta da promessa. O arquivo é uma tentativa de dar contexto a agentes de IA, tem uma lógica compreensível, mas não é um padrão formal e não aparece como requisito no guia do Google sobre recursos de IA, que aponta para indexação, elegibilidade a snippet e as práticas fundamentais de SEO. Nenhum arquivo, sozinho, assegura que a empresa será citada.
Para a presença digital, o que muda o resultado é a base: conteúdo claro, informações consistentes e um site bem estruturado. A Capta Marketing Digital, agência Google Partner com sede em Porto Alegre e atendimento para empresas de todo o Brasil, pode ajudar a avaliar a presença digital da sua empresa e a organizar a estrutura que sustenta a visibilidade nas buscas e nas respostas de IA.
Por Capta Marketing Digital
A Capta Marketing Digital é uma agência de marketing digital Google Partner especializada em geração de leads e captação de clientes. Desenvolvemos estratégias para aumentar o posicionamento e a visibilidade das empresas nos resultados do Google e nas respostas geradas por IAs, conectando sua marca aos clientes no momento em que eles estão pesquisando por produtos e serviços.
Com sede em Porto Alegre e atendimento para empresas de todo o Brasil, a Capta Marketing Digital reúne mais de 14 anos de experiência em marketing digital, mais de 120 projetos desenvolvidos e analistas certificados pelo Google em Google Ads.
A Capta Marketing Digital trabalha SEO e GEO dentro dos sites que desenvolve, com foco em presença digital estruturada, acompanhamento no Google Search Console e relatório unificado de GA4, Google Ads e Search Console.
Em um diagnóstico sem custo, identificamos os principais gargalos do seu marketing digital e por onde começar para gerar mais oportunidades.