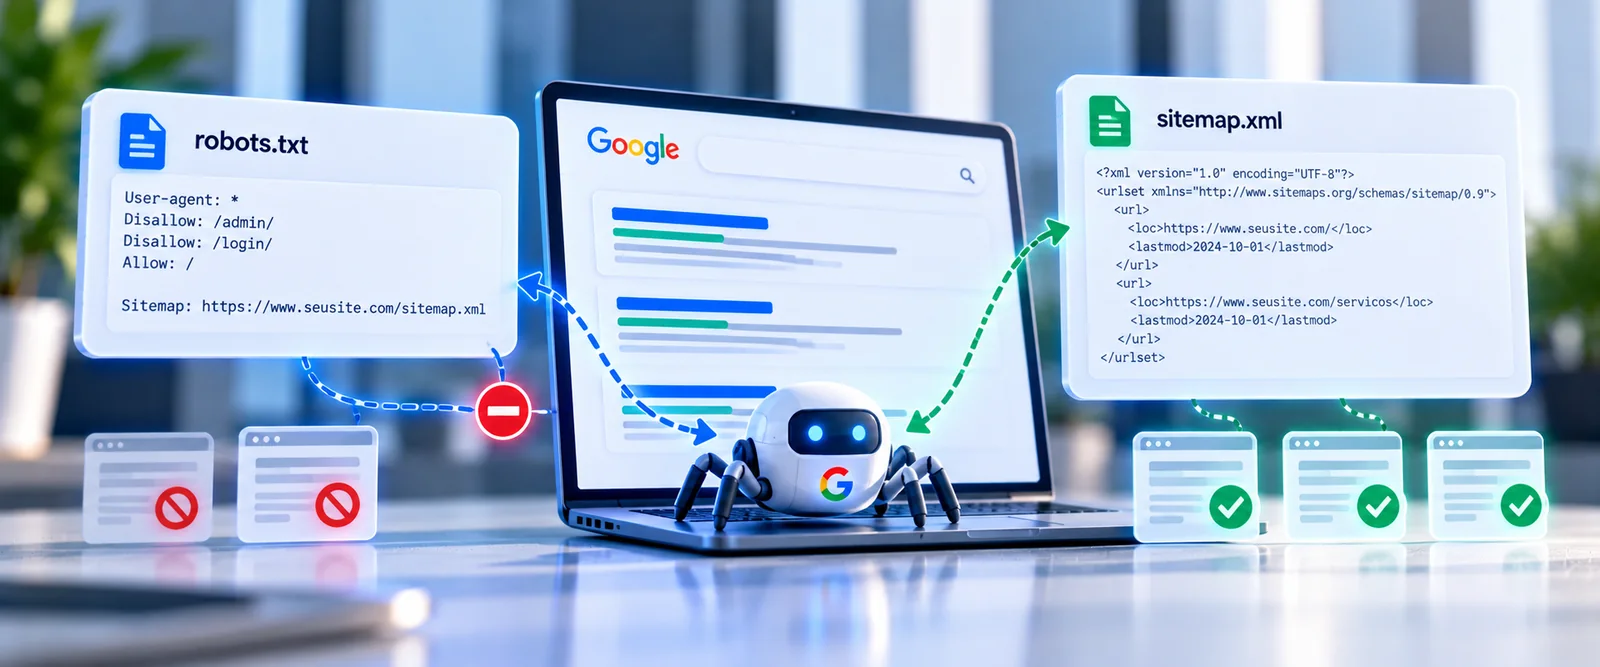
Quem conversa com um desenvolvedor sobre o site, ou abre um relatório de SEO, logo encontra dois nomes que parecem parentes: robots.txt e sitemap.xml. Os dois são arquivos do site, os dois "falam com o Google", e por isso costumam ser confundidos, inclusive com a ideia de que um deles "esconde" páginas ou "garante" que elas apareçam. Não é assim. Neste guia, a equipe da Capta Marketing Digital explica a diferença entre robots.txt e sitemap.xml em linguagem simples, mostrando em que etapa da busca cada um atua e o que nenhum dos dois faz.
O texto se baseia na documentação do Google Search Central. Não traz trechos de código nem regras de sintaxe, porque o objetivo é entender a função de cada arquivo. O exemplo é hipotético, e não há promessas de indexação, posição ou prazo.
Resposta direta: o robots.txt indica aos rastreadores quais URLs do site eles podem acessar, e seu uso principal é evitar sobrecarga do servidor. O sitemap.xml é uma lista das páginas e arquivos que a empresa considera importantes, e ajuda o Google a descobrir essas URLs. Nenhum dos dois garante que uma página seja indexada, e o robots.txt não serve para esconder uma página do Google. Um orienta o rastreamento, o outro apoia a descoberta, e a indexação continua sendo uma decisão do Google.
Em resumo:
- O Google trabalha em três etapas: descobrir e rastrear, indexar e exibir resultados.
- O robots.txt orienta o rastreamento, e não impede que uma página apareça nos resultados.
- O sitemap.xml ajuda na descoberta das URLs, e não garante rastreamento nem indexação.
- Para manter uma página fora do Google, a documentação indica noindex ou proteção por senha.
- Sites pequenos, com boa ligação entre as páginas, podem não precisar de sitemap, mas ele costuma ajudar.
- Combinar os dois sem critério é uma fonte comum de erros, e vale conferir no Search Console.
Como o Google encontra e guarda uma página?
Para entender os dois arquivos, é preciso ter em mente como funciona a Pesquisa. Segundo a documentação do Google sobre como a Pesquisa funciona, existem três etapas:
- Rastreamento: programas automáticos, chamados rastreadores (o principal é o Googlebot), encontram páginas e baixam seu conteúdo.
- Indexação: o Google analisa o conteúdo e o armazena no índice. Antes disso, agrupa páginas parecidas e escolhe a versão canônica.
- Exibição de resultados: quando alguém pesquisa, o Google busca no índice as páginas correspondentes e mostra as que considera mais relevantes e de maior qualidade.
Antes de rastrear, o Google precisa descobrir que a URL existe. A mesma documentação informa que isso acontece por três caminhos: páginas que ele já visitou, links em páginas conhecidas e listas de páginas enviadas pelo próprio site, os sitemaps. E há um aviso que vale para tudo o que segue: o Google não garante que vai rastrear, indexar ou exibir uma página, mesmo que ela siga as diretrizes. É com esse mapa em mente que os dois arquivos fazem sentido.
O que é o robots.txt e para que serve?
O robots.txt é um arquivo que fica na raiz do site e informa aos rastreadores quais URLs eles podem acessar. A documentação do Google sobre o robots.txt explica que seu uso principal é evitar que o servidor receba requisições demais.
O que ele faz: orientar o rastreamento
Na prática, o robots.txt serve para gerenciar o tráfego dos rastreadores. A documentação cita usos como evitar o rastreamento de páginas pouco importantes ou repetidas e, em arquivos de mídia, como imagens e vídeos, ajudar a impedir que apareçam nos resultados. Também é possível bloquear arquivos de recursos, como scripts e estilos, mas só se a página continuar funcionando bem sem eles, porque bloquear o que a página precisa pode prejudicar a análise do Google.
O que ele não faz: esconder páginas do Google
Este é o equívoco mais comum. A documentação afirma que o robots.txt não é um mecanismo para manter uma página fora do Google. Uma página bloqueada ainda pode aparecer nos resultados, com a URL e, às vezes, o texto de links que apontam para ela, mas sem descrição. Para ocultar uma página, a orientação é usar noindex ou proteção por senha.
Há ainda dois limites. Os rastreadores não são obrigados a obedecer ao arquivo: o Googlebot e outros rastreadores idôneos respeitam, mas outros podem ignorar. Por isso, conteúdo sensível deve ser protegido de verdade, e não apenas listado no robots.txt. E combinar regras de rastreamento e de indexação pode gerar conflitos, tema que o artigo sobre canonical, redirecionamento ou noindex aprofunda.
O que é o sitemap.xml e para que serve?
O sitemap é um arquivo com a lista das páginas, vídeos e outros arquivos que a empresa considera importantes, e com informações como a data da última atualização. Segundo a visão geral de sitemaps do Google, os mecanismos de busca leem esse arquivo para rastrear o site com mais eficiência.
O que ele faz: ajudar na descoberta das URLs
O sitemap funciona como uma lista entregue ao Google, e cumpre o terceiro caminho de descoberta descrito antes. Se as páginas estão bem ligadas entre si, o Google tende a encontrar a maior parte do site sozinho, mas o sitemap ajuda em sites grandes ou complexos, em sites novos com poucos links externos e em sites com muito conteúdo de mídia.
O que ele não garante
A própria documentação é direta: o sitemap não garante que todos os itens listados serão rastreados e indexados. Ele ajuda a descobrir, e o resto depende do Google. Por isso, listar uma página no sitemap não é o mesmo que "pedir" a indexação dela.
Qual é a diferença entre robots.txt e sitemap.xml?
A tabela resume o papel de cada arquivo, com base nas duas páginas da documentação.
| Critério | robots.txt | sitemap.xml |
|---|---|---|
| Etapa em que atua | Rastreamento | Descoberta das URLs |
| O que comunica | Quais URLs os rastreadores podem acessar | Quais páginas e arquivos a empresa considera importantes |
| Uso principal | Evitar sobrecarga do servidor e gerenciar o rastreamento | Ajudar o Google a encontrar as URLs com mais eficiência |
| Garante indexação? | Não | Não |
| Esconde páginas do Google? | Não. Pode ainda aparecer sem descrição | Não se aplica |
| Todo site precisa? | Depende da necessidade de gerenciar o rastreamento | Pode ser dispensável em sites pequenos e bem ligados |
| Risco principal | Bloquear páginas ou recursos que deveriam ser rastreados | Listar URLs que não deveriam estar ou deixar o arquivo desatualizado |
Meu site precisa dos dois?
Depende do porte e da estrutura. Sobre o sitemap, a documentação do Google indica que sites pequenos, com cerca de 500 páginas ou menos que devam aparecer nos resultados, ou com boa ligação interna, podem não precisar dele. Também afirma que, na maioria dos casos, o site se beneficia de ter um. Como recomendação de análise, a ausência de sitemap raramente é um problema grave em um site pequeno, mas tê-lo atualizado é uma boa prática e não custa caro.
Sobre o robots.txt, a pergunta é se há algo a gerenciar no rastreamento: áreas que não precisam ser rastreadas, páginas repetidas geradas por filtros ou recursos que consomem o servidor. Um site simples pode funcionar bem com um robots.txt básico, que não bloqueia o que importa. O ponto central é que o arquivo não deve bloquear páginas que a empresa quer que apareçam.
A ligação entre as páginas também faz diferença. O guia sobre links internos para SEO mostra como a organização dos links ajuda o Google a encontrar as páginas importantes, com ou sem sitemap.
Erros comuns e como conferir
- Bloquear o que deveria ser rastreado: uma regra aplicada por engano, por exemplo durante a construção do site, pode impedir o rastreamento de páginas importantes.
- Usar o robots.txt para "esconder" páginas: não funciona, e a página ainda pode aparecer sem descrição.
- Bloquear no robots.txt uma página que tem noindex: o Google não consegue ler a regra, e a página pode continuar nos resultados.
- Listar no sitemap páginas que não deveriam estar: como recomendação de análise, o sitemap deve conter as URLs preferidas. Versões duplicadas, páginas que redirecionam ou páginas com noindex contrariam essa ideia. O guia sobre conteúdo duplicado explica o problema da repetição.
- Deixar o sitemap desatualizado: páginas novas ficam de fora, e páginas removidas continuam na lista.
Para conferir, use o Search Console. Ele permite enviar o sitemap e acompanhar seu status pelo relatório de sitemaps, e o relatório de indexação de páginas mostra quais URLs foram indexadas e por que outras não foram. Se uma página importante sumiu dos resultados, o guia sobre páginas que perderam tráfego orgânico mostra como localizar a perda, e o artigo Search Console para iniciantes descreve uma rotina de acompanhamento.
Exemplo hipotético: o bloqueio que ficou depois do lançamento
Exemplo hipotético: uma empresa de serviços lança um site novo. Durante a construção, o desenvolvedor bloqueou no robots.txt a seção de serviços, para que as páginas não fossem rastreadas antes de ficarem prontas. Depois do lançamento, o bloqueio permaneceu, e o sitemap, gerado automaticamente, passou a listar todas as páginas de serviço.
O resultado é uma contradição: o sitemap diz ao Google que as páginas existem e são importantes, e o robots.txt diz que elas não podem ser rastreadas. O Google pode ficar sabendo das URLs, mas não consegue ler o conteúdo, e as páginas podem aparecer, quando aparecem, sem descrição. A empresa estranha a falta de visitas nas páginas mais importantes do site.
A correção, em ordem, é remover o bloqueio da seção, manter no sitemap apenas as URLs que devem aparecer e conferir no Search Console se as páginas passam a ser rastreadas e indexadas. O exemplo ilustra a diferença entre descoberta e rastreamento, e não um resultado esperado.
Como esses arquivos se conectam ao restante do SEO técnico?
Robots.txt e sitemap.xml são dois itens de uma base maior, que inclui indexação, canonical, redirecionamentos, velocidade e estrutura de links. O artigo sobre o que precisa estar certo antes do conteúdo situa esses arquivos entre os demais pontos técnicos. Em geral, eles precisam estar corretos para que o conteúdo possa ser encontrado, mas não bastam: conteúdo útil, estrutura e páginas bem pensadas continuam sendo o que sustenta a visibilidade.
Como esses arquivos se conectam a um site bem estruturado
Quando um site é criado já com a base técnica certa, o robots.txt e o sitemap deixam de ser uma preocupação do dia a dia e passam a ser parte da estrutura.
Na Capta Marketing Digital, o SEO é feito dentro dos sites e das landing pages que a agência cria, com a base técnica pensada para a busca orgânica e com o desempenho acompanhado no Search Console. A agência não faz auditoria de sites de terceiros.
Se você está planejando um site novo ou quer entender o que a estrutura técnica precisa ter, a página de criação de sites mostra como a agência desenvolve sites pensados para a captação de contatos, e a de SEO detalha o que ele envolve nos sites da Capta Marketing Digital.
Perguntas frequentes sobre robots.txt e sitemap.xml
O robots.txt esconde uma página do Google?
Não. Segundo a documentação, ele não é um mecanismo para manter uma página fora do Google. Uma página bloqueada ainda pode aparecer nos resultados, sem descrição. Para ocultá-la, use noindex ou proteção por senha.
O sitemap garante que minha página seja indexada?
Não. O sitemap ajuda o Google a descobrir as URLs, mas a documentação afirma que não garante rastreamento nem indexação de todos os itens listados.
Meu site pequeno precisa de sitemap?
Pode não precisar, se tiver poucas páginas e boa ligação entre elas, segundo a documentação. Ainda assim, o Google informa que, na maioria dos casos, o site se beneficia de ter um.
Posso bloquear uma página no robots.txt e usar noindex ao mesmo tempo?
Não é recomendável. O Google precisa rastrear a página para ler o noindex, e o bloqueio impede isso. A página pode continuar aparecendo nos resultados.
Como enviar o sitemap ao Google?
Pelo Search Console, no relatório de sitemaps, onde também é possível acompanhar o status. Quem cuida do site pode indicar o endereço do arquivo.
Conclusão: a diferença entre robots.txt e sitemap.xml está na etapa em que cada um atua
Entender a diferença entre robots.txt e sitemap.xml ajuda a não esperar de cada arquivo o que ele não faz. O robots.txt orienta o rastreamento e não esconde páginas, e o sitemap apoia a descoberta das URLs e não garante a indexação. Conferir o conteúdo dos dois e acompanhar o resultado no Search Console evita bloqueios por engano e listas desatualizadas.
Se a sua empresa quer um site com a base técnica pensada para a busca orgânica, conheça a página de SEO da Capta Marketing Digital, agência especialista em campanhas de geração de leads, com sede em Porto Alegre e atendimento para empresas de todo o Brasil, e avalie com a equipe o que faz sentido para o seu negócio.
Por Capta Marketing Digital
A Capta Marketing Digital é uma agência de marketing digital Google Partner especializada em geração de leads e captação de clientes. Desenvolvemos estratégias para aumentar o posicionamento e a visibilidade das empresas nos resultados do Google e nas respostas geradas por IAs, conectando sua marca aos clientes no momento em que eles estão pesquisando por produtos e serviços.
Com sede em Porto Alegre e atendimento para empresas de todo o Brasil, a Capta Marketing Digital reúne mais de 14 anos de experiência em marketing digital, mais de 120 projetos desenvolvidos e analistas certificados pelo Google em Google Ads.
A Capta Marketing Digital cria sites e landing pages pensados para a geração de leads, com estrutura para a busca orgânica e acompanhamento do desempenho.
Em um diagnóstico sem custo, identificamos os principais gargalos do seu marketing digital e por onde começar para gerar mais oportunidades.