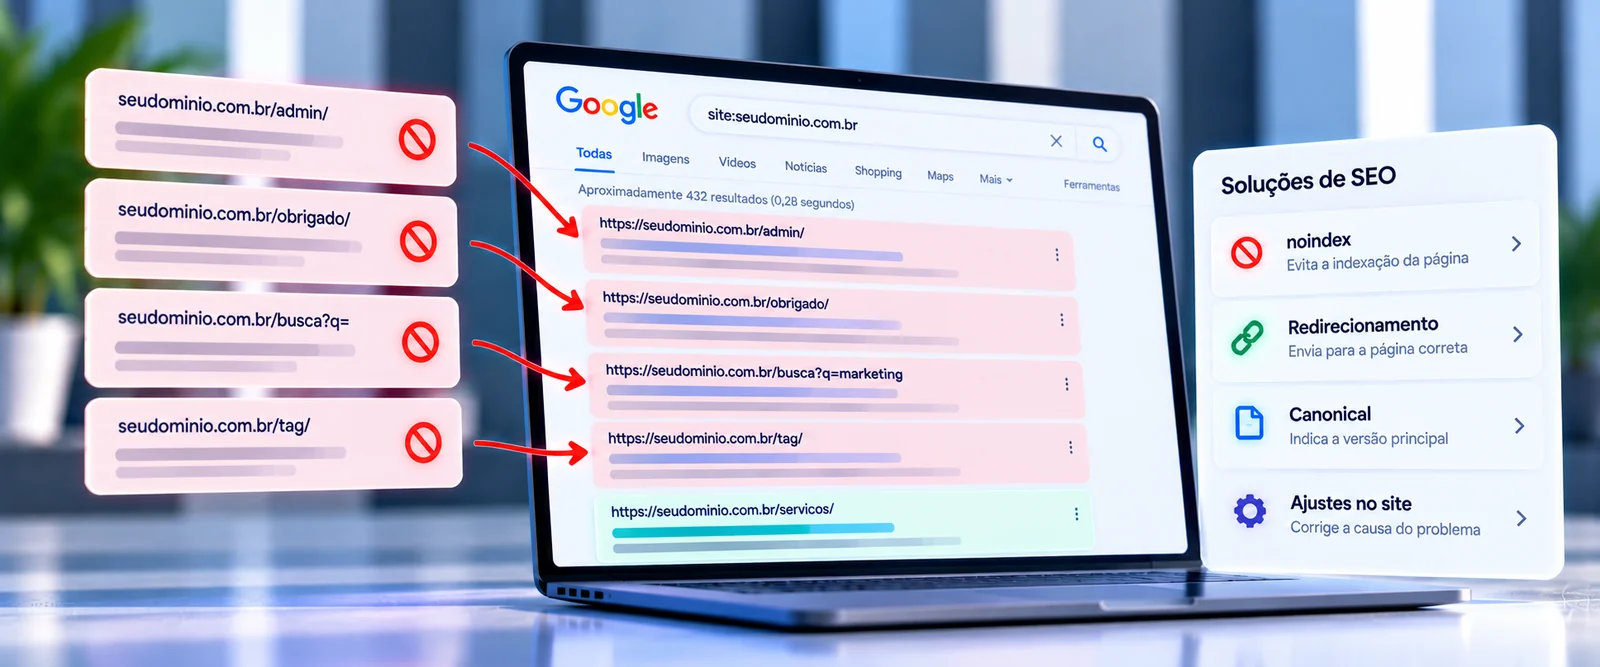
Você pesquisa o nome da empresa no Google e, entre os resultados, aparece uma página que não devia estar ali: uma versão de teste do site, uma página antiga, um arquivo interno ou uma proposta com informações que não eram para ser públicas. A reação mais comum é pedir ao desenvolvedor para "tirar do Google", e a solução aplicada nem sempre é a correta. Neste guia, a equipe da Capta Marketing Digital explica como diagnosticar por que as páginas indexadas que não deveriam aparecer no Google chegaram lá e como escolher entre remoção temporária, noindex, bloqueio de rastreamento e remoção do conteúdo.
O texto se baseia na documentação do Google Search Central e do Search Console. Não traz trechos de código, porque a implementação é feita por quem cuida do site, e o objetivo é ajudar você a decidir o que pedir. O texto não promete prazos de remoção. O exemplo é hipotético. Remover informações de sites que a empresa não controla, ou informações pessoais em páginas de terceiros, tem processo próprio no Google e está fora deste guia.
Resposta direta: se a página é sua e precisa sair do Google com urgência, use a ferramenta de remoções do Search Console, que a esconde dos resultados por cerca de seis meses, e aplique uma solução permanente antes do vencimento. A solução permanente depende do caso: remover ou atualizar o conteúdo, protegê-lo com senha ou adicionar noindex. O bloqueio no robots.txt não é o caminho, porque impede o rastreamento, mas não a indexação. A escolha começa por entender por que a página foi indexada e se ela ainda precisa existir.
Em resumo:
- A remoção temporária resolve a urgência, mas dura cerca de seis meses e não é permanente.
- Noindex mantém a página fora dos resultados do Google, mas o Google precisa rastreá-la para ver a instrução.
- O robots.txt não deve ser usado para tirar uma página do Google, e a página ainda pode aparecer nos resultados.
- Remover ou atualizar o conteúdo, ou protegê-lo com senha, são as formas mais seguras.
- Descobrir a causa evita que o problema volte a acontecer.
- Nenhuma solução tem prazo certo, e a confirmação vem do Search Console.
Por que uma página que não deveria aparecer foi indexada?
Antes de escolher a solução, vale entender a causa. O Google descobre páginas por links, por sitemaps e por páginas que já conhece, e indexa o que consegue rastrear, sem que a empresa precise "pedir". Como recomendação de análise, as causas mais comuns são:
- Página de teste ou de homologação liberada: uma versão do site criada para testes, sem proteção, que o Google encontra por algum link.
- Links apontando para a página: um link interno esquecido ou um link de outro site basta para o Google descobrir a URL.
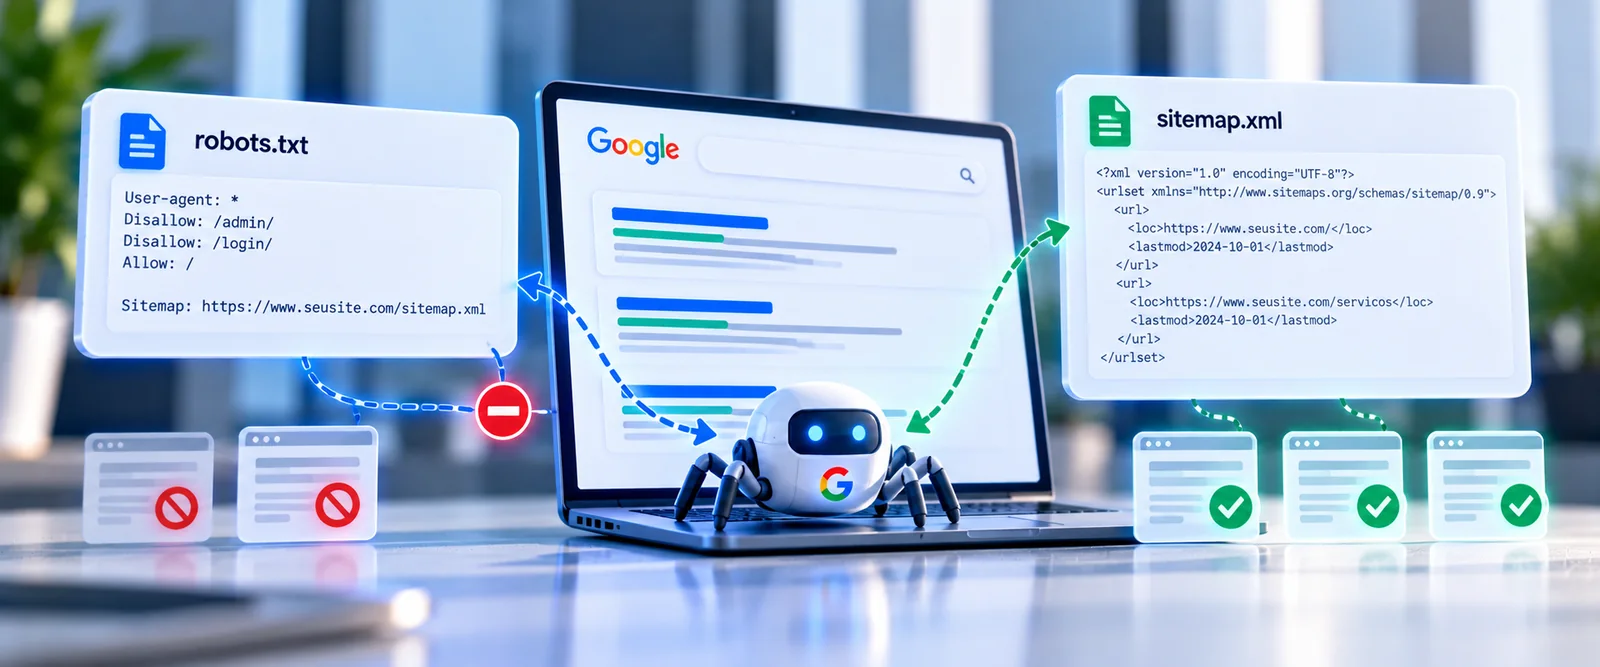
- Sitemap com URLs indevidas: o arquivo lista páginas que não deveriam estar nos resultados. A função do arquivo está no guia sobre robots.txt e sitemap.xml.
- Páginas geradas automaticamente: resultados de busca interna, filtros e variações de endereço que repetem conteúdo, tema tratado em conteúdo duplicado.
- Páginas antigas que continuam no ar: conteúdos descontinuados que nunca foram removidos nem redirecionados.
- Arquivos que não são páginas: PDFs e outros documentos publicados no site.
- Bloqueio aplicado do jeito errado: o robots.txt usado para "esconder" a página, o que não impede a indexação.
Saber a causa define a correção. Remover uma página que continua linkada, listada no sitemap e acessível tende a trazê-la de volta. O artigo sobre o que precisa estar certo antes do conteúdo situa esses pontos na base técnica do site.
Remoção temporária, noindex ou bloqueio de rastreamento: qual a diferença?
São quatro caminhos diferentes, com efeitos diferentes. A documentação do Google sobre como remover informações da Pesquisa organiza as opções, e a confusão entre elas é a principal causa de correções que não funcionam.
Remoção temporária (ferramenta do Search Console)
A ferramenta de remoções retira a página dos resultados em cerca de um dia, e a remoção dura cerca de seis meses. Segundo a documentação da ferramenta, ela não é permanente, não impede o rastreamento e remove o conteúdo apenas da Pesquisa Google, não de outros buscadores nem da internet. Também exige que a URL pertença a uma propriedade que você possui no Search Console e corresponda exatamente à que aparece nos resultados. O Google recomenda ainda proteger ou remover todas as variações da URL, porque endereços diferentes podem levar à mesma página.
É a resposta certa para a urgência, mas o próprio Google orienta aplicar uma solução permanente antes de a remoção expirar.
Noindex
O noindex é uma instrução que pede que a página não apareça nos resultados do Google. Ela pode ser colocada dentro da página ou enviada no cabeçalho da resposta do servidor, o que serve para arquivos como PDFs. O Google precisa rastrear a página para ver a instrução, e isso pode levar tempo, em alguns casos meses, segundo a documentação. A página continua acessível a quem tem o link, e outros buscadores que não aceitam a instrução podem mostrá-la. Por isso, o noindex serve para páginas úteis ao visitante, mas sem razão para aparecer na busca. O artigo canonical, redirecionamento ou noindex compara o noindex com os outros mecanismos.
Bloqueio de rastreamento (robots.txt)
O robots.txt orienta os rastreadores sobre quais URLs podem acessar. A documentação sobre remoção é direta: ele não deve ser usado para bloquear uma página. O relatório de indexação do Search Console explica o motivo: o robots.txt impede o rastreamento, mas não a indexação, e uma página bloqueada pode ser indexada se outras páginas apontarem para ela, em geral com descrição muito limitada. Pior, se a página tem noindex e está bloqueada, o Google não consegue ver a instrução.
Remover ou proteger o conteúdo
Remover ou atualizar o conteúdo é, segundo o Google, a opção mais segura, pois também impede que outros buscadores que não respeitam o noindex exibam a informação. Proteger a página com senha impede o acesso do Googlebot e de outros rastreadores, e mantém o acesso de quem é autorizado. Para páginas removidas, a documentação da ferramenta de remoções cita a resposta 404 ou 410 como forma de tornar a remoção permanente.
Como escolher a solução por cenário?
Quatro perguntas, na ordem, ajudam a decidir:
- A informação não pode ficar visível agora? Se sim, use a remoção temporária e, ao mesmo tempo, aplique uma solução permanente.
- A página ainda precisa existir? Se não, remova o conteúdo. Se havia uma página equivalente, um redirecionamento permanente pode levar o visitante a ela.
- Só pode ser vista por pessoas autorizadas? Proteja com senha.
- Precisa existir para o visitante, mas não aparecer na busca? Use noindex, sem bloquear a página no robots.txt.
Se as cópias da página precisam continuar acessíveis e o problema é a repetição, o caminho pode ser o canonical, e não a remoção. Essa decisão está no artigo sobre canonical, redirecionamento e noindex.
Tabela de cenários: situação, ação e o que evitar
A tabela aplica a documentação a situações comuns. A coluna "ação recomendada" é uma recomendação de análise, e não uma regra fixa.
| Situação | Ação recomendada | O que evitar | Como verificar |
|---|---|---|---|
| Informação que não podia ser pública está nos resultados | Remoção temporária e, em seguida, remover ou proteger o conteúdo | Usar apenas o robots.txt | Pesquisar a URL e acompanhar o status da remoção |
| Versão de teste do site liberada | Proteger com senha ou retirar do ar | Deixar acessível e contar com o robots.txt | Inspeção de URL |
| Página útil só ao visitante (agradecimento, área restrita) | Noindex | Bloquear no robots.txt junto com o noindex | Relatório de indexação |
| Página antiga sem equivalente | Remover o conteúdo (resposta 404 ou 410) | Manter no sitemap e linkada | Inspeção de URL e sitemap |
| Página antiga com substituta | Redirecionamento permanente | Redirecionamento temporário | Abrir o endereço antigo |
| Cópias que precisam coexistir | Canonical para a versão preferida | Noindex para escolher a versão | Inspeção de URL |
| PDF ou arquivo publicado por engano | Remover o arquivo ou aplicar noindex pelo cabeçalho | Esperar que saia sozinho | Pesquisar o arquivo |
| Aviso "indexada, embora bloqueada pelo robots.txt" | Retirar o bloqueio e usar noindex | Manter o bloqueio | Relatório de indexação |
O que o relatório de indexação mostra sobre esses casos?
O relatório de indexação de páginas do Search Console ajuda a confirmar o que está acontecendo. Dois status se destacam neste tema:
- "Indexada, embora bloqueada pelo robots.txt": o Google indexou a página mesmo sem poder rastreá-la. Se você não quer a página na Pesquisa, a orientação é remover o bloqueio do robots.txt e usar noindex.
- "Excluída pela tag noindex": o Google encontrou a instrução e não indexou a página. Se era a intenção, é o resultado esperado.
Para investigar uma URL específica, use a inspeção de URL, que mostra se a indexação é permitida e permite testar a versão ativa da página. O relatório informa ainda que a validação de uma correção pode levar até cerca de duas semanas, então acompanhe por mais de um dia. O guia sobre Search Console para iniciantes descreve uma rotina de acompanhamento, e, se uma página importante sumiu dos resultados após as mudanças, o texto sobre páginas que perderam tráfego orgânico ajuda a localizar o efeito.
Erros comuns que mantêm a página no Google
- Bloquear no robots.txt e esperar que a página saia: ela pode continuar nos resultados, sem descrição.
- Combinar noindex com bloqueio de rastreamento: o Google não vê a instrução.
- Usar só a remoção temporária: a página pode voltar quando a remoção expirar.
- Remover a página e deixá-la no sitemap ou linkada: o Google continua encontrando o endereço.
- Esquecer das variações do endereço: versões com parâmetros, com e sem barra final ou em outro protocolo podem continuar indexadas.
- Aplicar noindex a uma página que deveria aparecer: uma regra aplicada por engano a um modelo de página pode afetar um grupo inteiro. Confira as páginas estratégicas depois de qualquer mudança.
Exemplo hipotético: a página de teste que apareceu no Google
Exemplo hipotético: uma empresa de serviços percebe que, ao pesquisar o nome dela, aparece no Google uma versão de teste de uma página de serviço, com textos incompletos e um preço provisório. A página de teste ficou sem senha durante o desenvolvimento do site, e um link interno esquecido apontava para ela. Como medida inicial, alguém pediu ao desenvolvedor para bloqueá-la no robots.txt, mas a página continuou nos resultados.
A correção, em ordem, seria: usar a ferramenta de remoções para tirar a URL dos resultados enquanto a solução definitiva é aplicada; proteger a versão de teste com senha, ou retirá-la do ar; remover o link interno e qualquer menção no sitemap; retirar o bloqueio do robots.txt, que não resolvia e impedia o Google de ver a mudança; e acompanhar no Search Console se a URL deixa de ser indexada. O exemplo ilustra o raciocínio de diagnóstico, e não um resultado esperado nem um prazo.
Como evitar que aconteça de novo?
O problema costuma nascer em momentos de mudança. Um checklist simples antes de cada lançamento ou alteração reduz o risco:
- ambientes de teste protegidos por senha, e não apenas "escondidos";
- revisão do sitemap, para conter só as páginas que devem aparecer;
- conferência dos bloqueios e das instruções de noindex antes e depois do lançamento;
- revisão dos links internos para páginas descontinuadas;
- acompanhamento mensal do relatório de indexação, para perceber páginas inesperadas cedo.
Quando acionar apoio técnico?
Para uma página isolada, quem cuida do site costuma resolver em pouco tempo. Vale envolver quem cuida do SEO técnico quando muitas páginas aparecem indevidamente, quando há informação sensível exposta, quando as tentativas de correção não funcionam ou quando o site passou por uma migração recente. O apoio ajuda a diagnosticar a causa e a organizar as correções. Ele não substitui a decisão da empresa sobre quais páginas devem ou não aparecer.
Como a base técnica se conecta a um site bem estruturado
Páginas indexadas por engano costumam indicar falta de controle sobre o que é publicado e como. Quando o site é criado com a base técnica pensada desde o início, o risco diminui.
Na Capta Marketing Digital, o SEO é feito dentro dos sites e das landing pages que a agência cria, com a base técnica pensada para a busca orgânica e o desempenho acompanhado no Search Console. A agência não faz auditoria de sites de terceiros.
Se você está planejando um site novo ou quer entender o que a estrutura técnica precisa ter, a página de criação de sites mostra como a agência desenvolve sites pensados para a captação de contatos, e a de SEO detalha o que ele envolve nos sites da Capta Marketing Digital.
Perguntas frequentes sobre páginas indexadas que não deveriam aparecer
O robots.txt tira uma página do Google?
Não. Ele orienta o rastreamento, e a documentação diz que não deve ser usado para bloquear uma página. A página pode continuar nos resultados, em geral com descrição muito limitada.
A ferramenta de remoções apaga a página para sempre?
Não. A remoção dura cerca de seis meses e não impede o rastreamento. Para ser permanente, é preciso remover o conteúdo, proteger com senha ou usar noindex.
Quanto tempo leva para o noindex ter efeito?
Não há prazo definido. O Google precisa rastrear a página de novo para ver a instrução, o que pode levar tempo, em alguns casos meses, segundo a documentação. Solicitar um novo rastreamento pela inspeção de URL pode acelerar.
Posso apagar a página e esquecer?
Remover o conteúdo é a opção mais segura, e a resposta 404 ou 410 é indicada como forma de tornar a remoção permanente. Mas confira se a página não continua linkada ou listada no sitemap, e acompanhe no Search Console.
Como saber se a página saiu do Google?
Use a inspeção de URL e o relatório de indexação de páginas do Search Console, e pesquise a URL no Google. A validação de uma correção pode levar até cerca de duas semanas, segundo o relatório.
Conclusão: corrigir páginas indexadas que não deveriam aparecer começa pela causa
Para corrigir páginas indexadas que não deveriam aparecer no Google, o caminho é entender por que a página foi indexada, usar a remoção temporária quando houver urgência e aplicar uma solução permanente: remover ou proteger o conteúdo ou, quando a página precisa existir, usar noindex, sem bloqueá-la no robots.txt. Acompanhar o resultado no Search Console fecha o ciclo.
Se a sua empresa quer um site com a base técnica pensada para a busca orgânica e para evitar esse tipo de problema, conheça a página de SEO da Capta Marketing Digital, agência especialista em campanhas de geração de leads, com sede em Porto Alegre e atendimento para empresas de todo o Brasil, e avalie com a equipe o que faz sentido para o seu negócio.
Por Capta Marketing Digital
A Capta Marketing Digital é uma agência de marketing digital Google Partner especializada em geração de leads e captação de clientes. Desenvolvemos estratégias para aumentar o posicionamento e a visibilidade das empresas nos resultados do Google e nas respostas geradas por IAs, conectando sua marca aos clientes no momento em que eles estão pesquisando por produtos e serviços.
Com sede em Porto Alegre e atendimento para empresas de todo o Brasil, a Capta Marketing Digital reúne mais de 14 anos de experiência em marketing digital, mais de 120 projetos desenvolvidos e analistas certificados pelo Google em Google Ads.
A Capta Marketing Digital cria sites e landing pages pensados para a geração de leads, com estrutura para a busca orgânica e acompanhamento do desempenho.
Em um diagnóstico sem custo, identificamos os principais gargalos do seu marketing digital e por onde começar para gerar mais oportunidades.